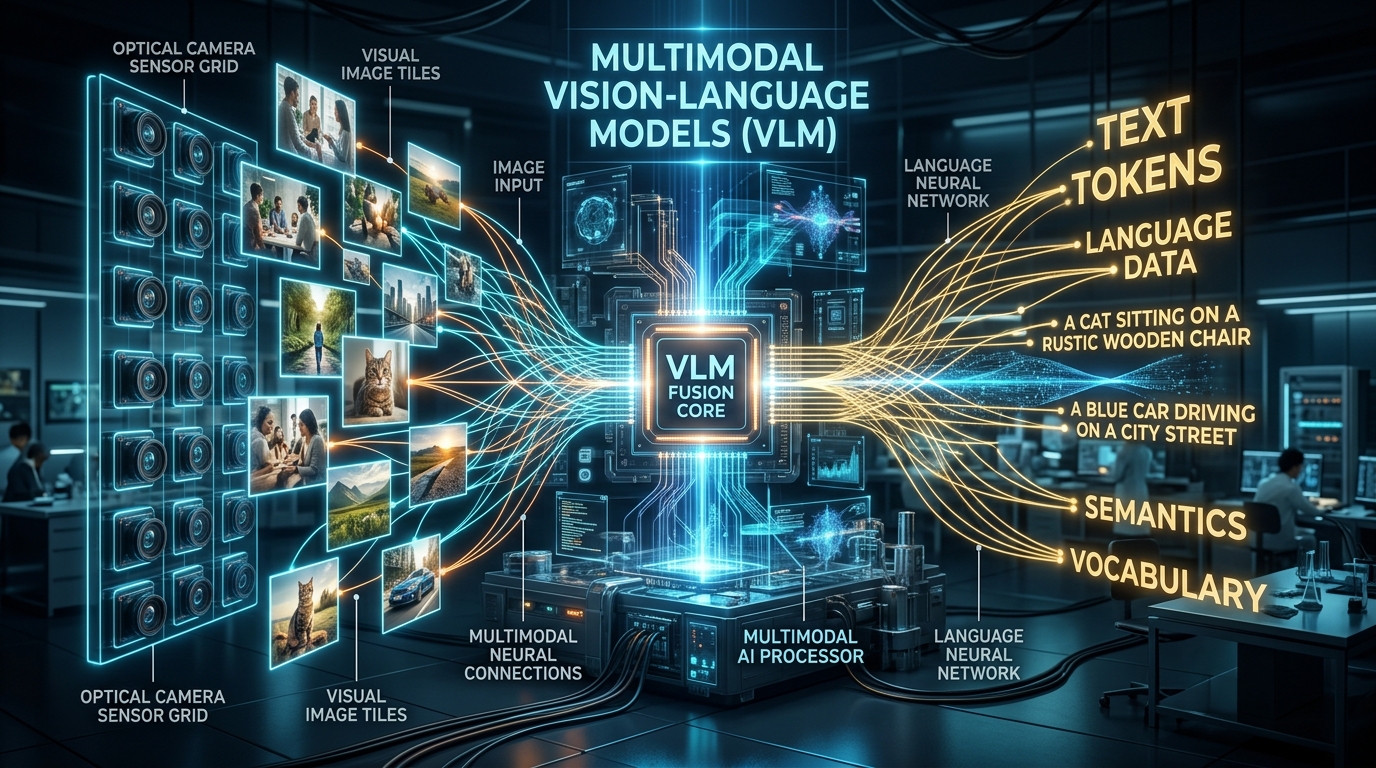
OpenAI의 GPT-4o, Google의 Gemini 1.5 Pro, 오픈소스 진영의 LLaVA, Qwen2-VL, InternVL에 이르기까지, 현대의 모든 첨단 AI 시스템은 시각과 언어를 하나의 신경망 안에서 통합 처리하는 구조를 채택하고 있습니다. 본 아티클에서는 상단 대표 다이어그램에 선명히 제시된 시각 센서 그리드(Optical Camera Sensor Grid)와 텍스트 토큰(Text Tokens)이 VLM 융합 코어(VLM Fusion Core)에서 결합되는 내부 메커니즘을 기초 수학 원리부터 엔터프라이즈 프로덕션 엔지니어링 파이프라인까지 낱낱이 파헤쳐 드립니다.
1. 텍스트 전용 패러다임의 한계와 심볼 그라운딩 문제 (Symbol Grounding Problem)
텍스트 기반 LLM은 방대한 텍스트 코퍼스를 학습하여 문법과 논리를 완벽히 구사하지만, 본질적으로 '기호 접지 문제(Symbol Grounding Problem)'라는 철학적·공학적 한계를 안고 있습니다.
예를 들어 모델이 "사과는 빨갛고 둥글며 단맛이 난다"라는 텍스트를 수조 번 반복 학습하더라도, 카메라로 들어오는 3차원 공간 속 실제 붉은 과일의 광학적 반사광 패턴이나 그림자, 굴절률의 물리적 실체를 알지 못합니다. 텍스트 기호가 물리 세계의 구체적 지각 경험(Sensory Experience)과 닿아있지 못하고 기호들 사이의 통계적 상관관계로만 표류하기 때문입니다.
멀티모달 VLM은 이 한계를 정면으로 돌파합니다. 고해상도 이미지 센서에서 취득된 RGB 픽셀 데이터를 언어의 의미론적 벡터 공간(Semantic Embedding Space)과 직접 정렬(Alignment)함으로써, 모델은 기호와 시각적 실체를 1:1로 결합하고 진정한 물리적 공간 인지 능력을 획득하게 됩니다.
2. 비전 인코더의 심장: Vision Transformer (ViT) 패치 투영 메커니즘
이미지는 본질적으로 2차원 또는 3차원의 연속된 픽셀 그리드입니다. 반면 트랜스포머 아키텍처는 이산적인 1차원 토큰 시퀀스를 입력으로 받도록 설계되었습니다. 이 이질적인 두 차원을 연결하는 핵심 알고리즘이 바로 2020년 구글 리서치가 발표한 Vision Transformer (ViT)입니다.
▶ 2.1 패치 분할(Patch Partitioning)과 선형 사영(Linear Projection)
ViT는 해상도 $H \times W$, 채널 $C$(보통 RGB 3채널)를 갖는 입력 이미지 $x \in \mathbb{R}^{H \times W \times C}$를 고정된 크기 $P \times P$(예: $14 \times 14$ 또는 $16 \times 16$ 픽셀)의 작은 사각 패치들로 격자 분할합니다.▶ 2.2 2차원 공간 위치 임베딩 (Positional Embedding)
합성곱 신경망(CNN)은 합성곱 커널 자체에 공간적 근접성을 파악하는 '귀납적 편향(Inductive Bias)'이 내장되어 있지만, 트랜스포머는 입력 순서에 무관한 순열 불변(Permutation Invariant) 성질을 갖습니다. 따라서 각 패치가 이미지의 좌측 상단인지, 중앙인지, 우측 하단인지를 모델에 알려주기 위해 고유한 2D 학습 가능 위치 임베딩(Positional Embeddings)을 각 패치 벡터에 더해줍니다.여기에 이미지 전체의 대표 특성을 요약하기 위한 특수 토큰인 [CLS] 토큰(Classification Token)이 시퀀스 맨 앞에 추가되어 최종적으로 $N + 1$개의 시각 토큰이 셀프 어텐션(Self-Attention) 레이어로 진입합니다.
3. 시각과 언어의 의미론적 정렬: CLIP 대조 학습(Contrastive Learning)
비전 인코더가 이미지의 특징을 벡터로 뽑아낼 수 있게 되었다고 해서, 그 벡터가 곧바로 언어의 단어와 통하는 것은 아닙니다. 비전 임베딩과 언어 임베딩을 하나의 공유된 다차원 잠재 공간(Shared Latent Space)에 나란히 정렬시킨 일등 공신이 바로 OpenAI의 CLIP (Contrastive Language-Image Pre-training)입니다.
▶ 3.1 양방향 대칭 대조 손실 (Symmetric Cross-Entropy Loss)
배치 크기 $B$개의 (이미지, 텍스트) 쌍이 주어졌을 때, 비전 인코더는 $B$개의 정규화된 이미지 벡터 $\{I_1, I_2, \dots, I_B\}$를 생성하고, 텍스트 인코더는 $B$개의 텍스트 벡터 $\{T_1, T_2, \dots, T_B\}$를 생성합니다.이들 사이의 코사인 유사도 행렬 $S_{ij} = I_i \cdot T_j^\top / \tau$ (여기서 $\tau$는 학습 가능한 온도 매개변수)를 계산하면 $B \times B$ 크기의 정방 행렬이 완성됩니다.
이 대조 학습을 인터넷에서 수집한 4억 개 이상의 대규모 (이미지-캡션) 데이터셋으로 사전 학습하면, 상단 이미지 우측에 묘사된 "A cat sitting on a rustic wooden chair"라는 텍스트 토큰과 좌측의 실제 고양이 사진 시각 패치 벡터가 잠재 공간상에서 거의 일치하는 좌표에 위치하게 됩니다.
4. VLM 융합 아키텍처: 어텐션 프로젝터와 시각 토큰 주입
CLIP의 비전 인코더가 생성한 시각 임베딩을 대규모 언어 모델(LLM)의 두뇌와 결합하는 방식에는 여러 가지 설계 철학이 존재합니다. 대표적인 4대 융합 패러다임을 비교해 보겠습니다.
| 아키텍처 패턴 | 대표 모델 | 시각-언어 융합 메커니즘 | 장점 및 특징 | 단점 및 트레이드오프 |
| :--- | :--- | :--- | :--- | :--- |
| Linear MLP Projector | LLaVA v1.5, LLaVA-NeXT | 2단 MLP(GELU 활성화)로 비전 차원을 LLM 차원으로 단순 사영 | 구조가 극도로 단순하며 학습 수렴이 빠르고 시각 세부 정보 보존 우수 | 토큰 수가 줄어들지 않아 긴 컨텍스트 비용 발생 |
| Perceiver Resampler | DeepMind Flamingo, IDEFICS | 고정된 개수(예: 64개)의 학습 가능 쿼리를 사용하는 Cross-Attention | 이미지 해상도에 무관하게 시각 토큰 수를 일정하게 압축 가능 | 미세한 픽셀 레벨 텍스트(OCR) 정보 손실 가능성 |
| Cross-Attention Layer | Llama 3.2-Vision | LLM 디코더 중간중간에 비전 토큰을 참조하는 교차 어텐션 레이어 삽입 | 텍스트 LLM 가중치를 완벽 동결(Freeze)한 채 멀티모달 확장 용이 | 메모리 오버헤드 증가 및 아키텍처 복잡도 상승 |
| Unified Native ViT | Gemini 1.5, Chameleon | 초기 입력단부터 음성, 이미지 패치, 텍스트 토큰을 단일 트랜스포머에서 직접 학습 | 이기종 모달리티 간 완벽한 엔드투엔드 시너지 | 막대한 사전 학습 연산 비용과 데이터 불균형 위험 |
▶ LLaVA 스타일의 MLP 프로젝터 작동 원리
오늘날 가장 널리 사용되는 오픈소스 표준인 LLaVA(Large Language and Vision Assistant)는 직관적이면서도 강력한 구조를 자랑합니다. 1. 이미지 $X_v$가 사전 학습된 ViT(CLIP-ViT-L/14)를 통과하여 시각 특성 그리드 $Z_v \in \mathbb{R}^{N \times D_v}$로 변환됩니다. 2. 경량화된 2계층 다층 퍼셉트론(MLP) 프로젝터 $W$를 통해 LLM의 은닉 차원 $D_t$로 매핑됩니다: $$H_v = W_2 \cdot \text{GELU}(W_1 \cdot Z_v)$$ 3. 변환된 시각 토큰 시퀀스 $H_v$는 시스템 프롬프트 및 사용자 텍스트 질문 토큰 $H_q$의 앞단에 단순 연결(Concatenation)되어 단일 시퀀스 $[H_v, H_q]$를 구성합니다. 4. LLM 디코더(예: Vicuna, Llama 3, Qwen)는 이 결합된 시퀀스를 일반적인 자기회귀(Autoregressive) 방식으로 읽어 들이며 다음 텍스트 토큰을 생성합니다.5. 고해상도 시각 인지의 혁신: AnyRes와 Dynamic Patch Partitioning
초기 VLM의 가장 치명적인 약점은 $224 \times 224$나 $336 \times 336$과 같은 저해상도 입력만 처리할 수 있어, 이미지 속 작은 영수증 글자, 도표의 수치, 복잡한 설계도면을 인식하지 못하고 환각(Hallucination)을 일으킨다는 점이었습니다.
이 한계를 극복하기 위해 등장한 현대 기술이 바로 AnyRes(Any Resolution) 동적 격자 분할 기술입니다.
1. 종횡비 보존 그리드 분할: 4K 해상도의 직사각형 이미지가 들어오면, 원본의 가로세로 비율(Aspect Ratio)을 계산하여 가장 왜곡이 적은 그리드(예: $2 \times 2$, $1 \times 3$, $3 \times 2$ 등 최대 6개 블록)로 이미지를 고해상도 크롭합니다. 2. 글로벌 썸네일(Global Thumbnail): 크롭된 세부 타일들 외에, 이미지 전체를 $336 \times 336$으로 리사이즈한 축소판 썸네일을 하나 별도로 생성합니다. 3. 이중 스케일 토큰 결합: 글로벌 썸네일은 전체적인 구도와 배경 맥락을 제공하고, 로컬 서브 타일들은 미세한 텍스트와 객체의 디테일을 담당합니다. 4. 개행 토큰(Newline Token) 주입: 2D 공간의 행 구분을 LLM이 인식할 수 있도록 각 서브 타일 행의 끝에 특수 개행 토큰(`\n`)을 삽입하여 시각적 2D 레이아웃을 텍스트 공간 구조로 완벽히 재현합니다.
이 방식을 통해 모델은 추가적인 비전 인코더 재학습 없이도 4K 이상의 초고해상도 문서 OCR과 복잡한 차트 분석을 98% 이상의 정확도로 수행할 수 있게 되었습니다.
6. 프로덕션 서빙과 엔지니어링 최적화 파이프라인
실무 환경에서 VLM을 서비스할 때 가장 큰 병목은 시각 토큰으로 인한 연산 및 VRAM 메모리 폭증입니다. 단 한 장의 고해상도 이미지가 2,000개 이상의 토큰을 소비하기 때문에, 여러 장의 이미지나 비디오 프레임을 처리할 경우 초당 생성 속도가 급감합니다.
▶ 6.1 KV 캐시 재사용과 시각 프리필(Visual Prefill) 최적화
실시간 챗봇 환경에서는 사용자가 이미지를 한 번 업로드한 뒤 여러 번 연속해서 질문을 던지는 멀티턴(Multi-turn) 대화가 빈번합니다.▶ 6.2 혼합 정밀도 양자화 (Mixed-Precision AWQ / GPTQ)
7. 미래 전망: 자율 로보틱스와 체화된 인공지능 (Embodied AI)
비전-언어 모델의 진화는 모니터 화면 속 텍스트와 픽셀의 결합에 머무르지 않고, 물리적 신체를 가진 로봇의 제어 뇌로 진화하고 있습니다. 이를 Vision-Language-Action (VLA) 모델이라고 부릅니다.
Google DeepMind의 RT-2(Robotic Transformer 2)와 최신 공간 지능(Spatial Intelligence) 연구들은 VLM의 출력 토큰 공간에 로봇 관절의 6자유도 이동 좌표(End-Effector XYZ Roll-Pitch-Yaw)와 그리퍼 열림/닫힘 제어 명령을 직접 토큰화하여 통합했습니다.
"테이블 위의 넘어진 사이다 캔을 주워서 쓰레기통에 버려줘"라는 자연어 지시를 받으면, VLA 모델은: 1. 카메라 시각 패치로부터 사이다 캔의 정확한 3차원 바운딩 박스와 무게 중심을 추론하고, 2. 장애물을 회피하는 최적의 팔 궤적(Trajectory)을 연속된 수치 토큰으로 생성하여, 3. 모터를 정밀하게 구동합니다.