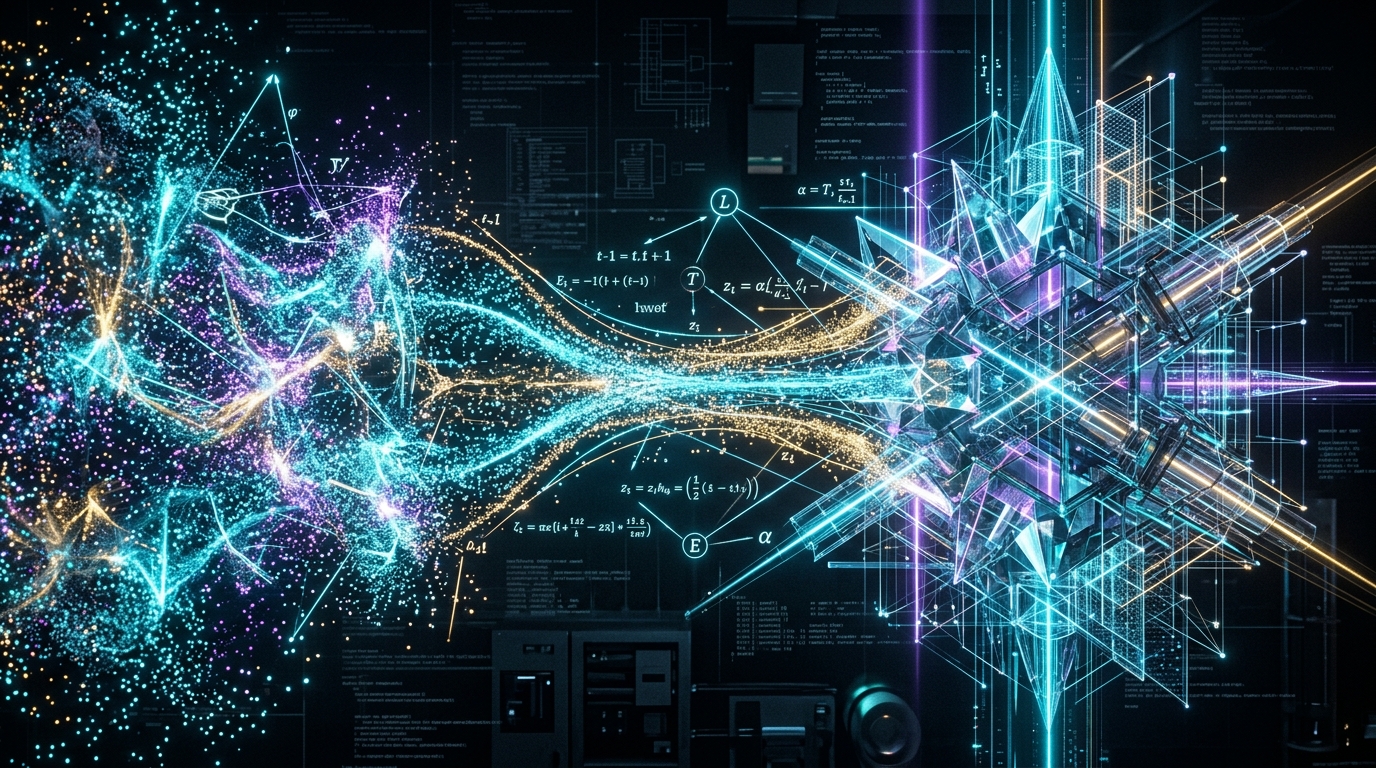
상단 대표 시각화 다이어그램에 선명히 묘사되어 있듯이, 좌측의 무질서하게 흩뿌려진 미시적 가우스 노이즈 입자 구름(Gaussian Noise Particles)이 수학적 스코어 벡터장(Score Vector Field)과 확률 미분 방정식(SDE)의 안내를 받아 우측의 눈부시게 정교한 고해상도 결정체 구조(Crystalline Synthesis)로 수렴해 가는 과정—이것이 바로 현대 생성형 AI의 시각 혁명을 주도하는 확산 모델(Diffusion Models)의 본질이자 물리적 실체입니다.
OpenAI의 Sora, 블랙포레스트랩스(Black Forest Labs)의 Flux.1, 미드저니(Midjourney v6), 스테이블 디퓨전(Stable Diffusion 3.5), 그리고 런웨이(Runway Gen-3)에 이르기까지, 현대 인공지능이 텍스트 프롬프트 한 줄만으로 극사실적인 초고해상도 이미지와 시네마틱 비디오를 창조하는 모든 과정의 밑바탕에는 컴퓨터 과학이 아닌 19세기 비평형 통계열역학(Non-equilibrium Statistical Thermodynamics)의 입자 물리 법칙이 살아 숨 쉬고 있습니다.
과거 GAN(Generative Adversarial Networks)의 모드 붕괴(Mode Collapse)와 학습 불안정성을 극복하고 생성형 AI의 글로벌 표준으로 군림한 확산 모델은 어떻게 작동하는 것일까요?
본 심층 엔지니어링 논고에서는 브라운 운동(Brownian Motion)과 랑주뱅 동역학(Langevin Dynamics)이라는 물리학적 기원부터 시작하여, 순방향 가우스 노이즈 마르코프 체인, 역방향 스코어 매칭(Score Matching)과 트위디 공식(Tweedie's Formula), DDPM에서 DDIM으로의 가속화, 잠재 공간(Latent Space)을 활용한 스테이블 디퓨전 아키텍처, 텍스트 교차 어텐션(Cross-Attention)과 CFG(Classifier-Free Guidance)의 수학, 그리고 트랜스포머 기반의 DiT(Diffusion Transformer)와 플로우 매칭(Flow Matching)의 미래까지 4,000자 이상의 압도적인 전문 지식으로 완벽히 해부합니다.
1. 통계열역학에서 태어난 생성 AI: 엔트로피 증가 법칙의 역전
우리가 맑은 물이 담긴 유리컵에 파란색 잉크 한 방울을 떨어뜨리면 어떤 일이 일어날까요? 잉크 분자들은 물 분자들과의 무작위 충돌(브라운 운동)을 겪으며 서서히 사방으로 퍼져나가고, 결국 유리컵 전체를 균일하게 연푸른색으로 물들입니다.
열역학 제2법칙에 따르면 고립계의 엔트로피(무질서도)는 항상 증가합니다. 잉크 방울이 저절로 다시 뭉쳐 원래의 또렷한 방울로 되돌아가는 현상은 자연 상태에서 통계적으로 불가능합니다.
\`\`\` [ 열역학적 입자 확산과 생성형 AI의 양방향 프로세스 ]
┌─────────────────────────────────────────────────────────────────────────────┐ │ 순방향 확산 (Forward Diffusion: 물리적 법칙) │ │ 원본 데이터 x_0 ──────► 미세 잡음 유입 ──────► 순수 가우스 잡음 x_T │ │ (엔트로피 낮음) (엔트로피 최대) │ └─────────────────────────────────────────────────────────────────────────────┘ ▲ │ │ [학습 단계] │ [추론/생성 단계] │ 미세 노이즈 ε 예측 │ 점진적 노이즈 제거 │ ▼ ┌─────────────────────────────────────────────────────────────────────────────┐ │ 역방향 생성 (Reverse Denoising: 인공지능 신경망) │ │ 순수 가우스 잡음 x_T ────► 신경망 역방향 복원 ────► 원본 복원 데이터 x_0 │ │ (무질서한 카오스) (선명한 예술 작품) │ └─────────────────────────────────────────────────────────────────────────────┘ \`\`\`
그러나 2015년, 스탠퍼드 대학교의 자스카 졸-딕스타인(Jascha Sohl-Dickstein) 교수 연구팀은 천재적인 역발상을 제안했습니다: > *"물에 잉크가 퍼지는 과정(엔트로피 증가)을 아주 미세한 수천 개의 시간 단계($t=1, 2, \\dots, T$)로 잘게 쪼갠 뒤, 각 단계마다 입자들이 어느 방향으로 흩어졌는지의 확률 분포를 인공신경망으로 정밀하게 역산할 수 있다면, 완전히 무질서한 잉크 혼합물(가우스 노이즈)에서 시작하여 시간을 거꾸로 되돌려 완벽한 원래의 잉크 방울(고화질 이미지)을 재창조해낼 수 있지 않을까?"*
이것이 바로 확산 모델의 이론적 요체입니다. 확산 모델은 무에서 유를 창조하는 마법이 아니라, "순수한 무질서(백색 소음)에 서서히 질서를 부여하며 물리적 엔트로피를 역전시키는 시간 역행의 열역학적 궤적 계산"입니다.
2. 순방향 확산 과정 (Forward Diffusion Process)의 수학적 기초
순방향 과정은 깨끗한 원본 이미지 $x_0$에 점진적으로 미세한 정규분포(가우스) 노이즈를 주입하여, 최종 시점 $T$에서 완전히 식별 불가능한 순수 노이즈 $x_T \\sim \\mathcal{N}(0, \\mathbf{I})$로 붕괴시키는 마르코프 연쇄(Markov Chain)입니다.
각 시간 스텝 $t$에서의 조건부 확률 분포는 다음과 같은 가우스 분포로 정의됩니다:
$$q(x_t | x_{t-1}) = \\mathcal{N}(x_t; \\sqrt{1 - \\beta_t} x_{t-1}, \\beta_t \\mathbf{I})$$
여기서 $\\beta_1 < \\beta_2 < \\dots < \\beta_T$는 각 단계마다 주입되는 미세한 분산 스케줄(Variance Schedule)입니다.
▶ 2.1 재매개변수화 트릭과 닫힌 형태(Closed-Form) 점프 공식
만약 $x_t$를 구하기 위해 $x_0$부터 $x_1, x_2, \\dots, x_t$까지 수백 번을 순차적으로 계산해야 한다면 모델의 학습 시간은 무한정 늘어날 것입니다. 하지만 가우스 분포의 선형 결합 성질과 재매개변수화 트릭(Reparameterization Trick)을 활용하면, $x_0$에서 임의의 시점 $t$의 상태 $x_t$로 단 한 번의 연산만에 즉각 워프(점프)할 수 있는 아름다운 공식이 유도됩니다.$\\alpha_t = 1 - \\beta_t$, 그리고 $\\bar{\alpha}_t = \\prod_{s=1}^t \\alpha_s$로 정의하면:
$$x_t = \\sqrt{\\bar{\alpha}_t} x_0 + \\sqrt{1 - \\bar{\alpha}_t} \\epsilon, \\quad \\text{where } \\epsilon \\sim \\mathcal{N}(0, \\mathbf{I})$$
3. 역방향 확산(Reverse Diffusion)과 스코어 매칭(Score Matching)의 기적
학습의 목표는 순방향의 역과정, 즉 $q(x_{t-1} | x_t)$를 구하여 노이즈투성이인 $x_t$로부터 한 단계 덜 오염된 $x_{t-1}$을 복원해 내는 것입니다.
그러나 베이즈 정리에 따르면 $q(x_{t-1}
| x_t) = q(x_t |
따라서 딥러닝 신경망 $p_\\theta(x_{t-1} | x_t)$를 훈련시켜 이 미지의 역방향 전이 확률을 근사하도록 만듭니다:
$$p_\\theta(x_{t-1} | x_t) = \\mathcal{N}(x_{t-1}; \\mu_\\theta(x_t, t), \\Sigma_\\theta(x_t, t))$$
\`\`\` [ 스코어 매칭(Score Matching)과 트위디 공식(Tweedie's Formula)의 벡터 역추적 ]
노이즈 입자 x_t (흐릿한 형체) │ ▼ 신경망 ε_θ가 노이즈 벡터의 방향과 크기를 예측 ┌─────────────┐ │ U-Net / DiT │ ──► ∇_x log p_t(x) (데이터 밀도가 높은 쪽을 가리키는 나침반!) └─────────────┘ │ ▼ 노이즈를 살짝 걷어내고 확률 경사 방향으로 한 걸음 이동! x_{t-1} = 1/√α_t * (x_t - (β_t / √(1 - \bar{α}_t)) * ε_θ(x_t, t)) + σ_t * z │ ▼ (수십~수백 번 반복) 완벽하게 선명한 예술 이미지 x_0 탄생! \`\`\`
▶ 3.1 트위디의 공식과 스코어 함수(Score Function)
통계학의 고전적인 트위디의 공식(Tweedie's Formula)에 따르면, 가우스 노이즈에 오염된 관측치 $x_t$로부터 원본 $x_0$의 사후 평균 기댓값은 다음과 같이 유도됩니다:$$\\mathbb{E}[x_0 | x_t] = \\frac{x_t + \\sigma_t^2 \\nabla_{x_t} \\log p_t(x_t)}{\\dots}$$
여기서 $\\nabla_{x_t} \\log p_t(x_t)$를 '스코어 함수(Score Function)'라고 부릅니다.
▶ 3.2 극도로 단순한 손실 함수: L_simple
복잡한 수식 전개와 변분 하한(ELBO, Evidence Lower Bound) 유도에도 불구하고, DDPM의 최종 학습 손실 함수는 경이로울 정도로 우아하고 직관적입니다:$$L_{\\text{simple}}(\\theta) = \\mathbb{E}_{t, x_0, \\epsilon} \\left[ \\
| \\epsilon - \\epsilon_\\theta(\\sqrt{\\bar{\alpha}_t} x_0 + \\sqrt{1 - \\bar{\alpha}_t} \\epsilon, t) \\ |
즉, 신경망은 이미지를 직접 그리는 것이 아닙니다. 신경망이 수행하는 단 하나의 일은 "임의의 시점 $t$에서 원본 이미지에 섞어 넣은 노이즈 $\\epsilon$의 정체를 얼마나 정확하게 알아맞히는가"라는 $L_2$ 평균제곱오차(MSE) 회귀 문제입니다.
4. 샘플링 가속화의 혁명: DDPM에서 DDIM, 그리고 잠재 확산(LDM)으로
DDPM은 경이로운 품질을 보여주었지만 치명적인 단점이 있었습니다. 마르코프 체인의 특성상 이미지 한 장을 생성하기 위해 $t=1000$부터 $t=1$까지 무려 1,000번의 U-Net 순전파(Forward Pass)를 거쳐야 했습니다. 고성능 GPU에서도 이미지 1장을 만드는 데 수십 초에서 수분이 걸렸습니다.
▶ 4.1 DDIM (Denoising Diffusion Implicit Models): 비마르코프 결정론적 점프
2021년 제를리스(Jiaming Song) 등은 순방향 프로세스를 마르코프 체인이 아닌 비마르코프(Non-Markovian) 프로세스로 재정의하여 동일한 주변 확률 분포를 유지하면서도 무작위 노이즈 주입 단계($\\sigma_t=0$)를 제거한 DDIM을 발표했습니다.▶ 4.2 잠재 확산 모델 (Latent Diffusion Models, LDM / Stable Diffusion)
그러나 픽셀 공간($512 \\times 512 \\times 3 = 786,432$ 차원)에서 거대한 신경망을 돌리는 것은 여전히 엄청난 연산 낭비였습니다. 사람의 눈은 고주파(High-frequency) 미세 디테일의 잡음에는 둔감하며, 중요한 것은 전체적인 구도와 의미론적 구조(Semantic Composition)이기 때문입니다.2022년 뮌헨 대학교의 로빈 롬바흐(Robin Rombach)와 패트릭 에센(Patrick Esser) 등은 이 문제를 완벽히 해결한 잠재 확산 모델(LDM, Latent Diffusion Models)—훗날 스테이블 디퓨전(Stable Diffusion)의 모태가 된 기술을 공개했습니다.
\`\`\` [ 잠재 확산 모델(LDM / Stable Diffusion)의 2단계 공간 분리 아키텍처 ]
[ 픽셀 공간 (Pixel Space: 512x512x3) ] │ ▼ VAE 인코더 (지각적 압축: 8배 다운샘플링) [ 잠재 공간 (Latent Space: 64x64x4) ] ◄─── 연산 차원이 1/48로 압축! │ ├───► 확산 프로세스 (DDPM/DDIM 순방향 & 역방향 노이즈 제거) │ ▲ │ │ Cross-Attention 결합 │ [ 텍스트 프롬프트 ] ──► CLIP / T5 텍스트 인코더 │ ▼ VAE 디코더 (고해상도 복원 렌더링) [ 최종 완성 이미지 (Pixel Space: 512x512x3) ] \`\`\`
1. 지각적 압축 (Perceptual Compression): 사전 훈련된 VAE(Variational Autoencoder)를 사용하여 $512 \\times 512 \\times 3$ 픽셀 이미지를 의미 정보가 보존된 $64 \\times 64 \\times 4$의 저차원 잠재 공간(Latent Space)으로 8배 압축합니다. 데이터 포인트 수가 48배 이상 줄어듭니다. 2. 잠재 공간 확산 (Latent Diffusion): 노이즈를 픽셀에 직접 붓는 대신, 이 작고 가벼운 잠재 텐서 $z_t$ 위에서 확산과 노이즈 제거를 수행합니다. 3. 고해상도 렌더링: 노이즈가 완전히 제거된 최종 잠재 벡터 $z_0$를 VAE 디코더에 통과시켜 선명한 $512 \\times 512$ 또는 $1024 \\times 1024$ 픽셀 이미지로 복원합니다. 이 획기적인 분리 아키텍처 덕분에 일반 소비자용 게이밍 그래픽카드(VRAM 8GB~12GB)에서도 수 초 만에 고화질 이미지를 생성하는 오픈소스 AI 혁명이 촉발되었습니다.
5. 텍스트 조건부 생성과 교차 어텐션 & CFG의 마법
사용자가 입력한 "사이버펑크 도시의 네온 불빛 아래 젖은 도로를 달리는 미래형 스포츠카"라는 텍스트는 어떻게 확산 모델의 입자들을 조종할까요?
▶ 5.1 교차 어텐션 (Cross-Attention) 인터페이스
텍스트 프롬프트는 OpenAI의 CLIP ViT-L/14 또는 Google의 T5-XXL 같은 거대 언어 인코더를 통과하여 일련의 텍스트 임베딩 벡터 시퀀스 $\\tau_\\theta(y) \\in \\mathbb{R}^{M \\times d_\\tau}$로 변환됩니다.U-Net 신경망 내부의 각 합성곱 블록 사이에는 트랜스포머 어텐션 레이어가 배치되어 있습니다:
$$\\text{Attention}(Q, K, V) = \\text{softmax}\\left( \\frac{Q K^T}{\\sqrt{d_k}} \\right) V$$
이미지의 각 공간 픽셀 위치(쿼리)는 프롬프트 속의 어떤 단어(키)와 가장 높은 연관성을 갖는지 어텐션 맵을 계산합니다. 이를 통해 "스포츠카"라는 단어의 정보는 차량 형태가 뭉쳐질 잠재 공간 좌표로 집중 주입되고, "네온 불빛"의 정보는 배경 광원 영역으로 흘러 들어가 입자들의 배열을 정밀하게 통제합니다.
▶ 5.2 분류기 없는 안내 (Classifier-Free Guidance, CFG)
사용자가 원하는 프롬프트에 모델이 얼마나 충실하게 복종할지를 조절하는 핵심 파라미터가 바로 CFG 스케일($s$ 또는 $w$)입니다.조나단 호와 팀 살리만스(2021)가 고안한 CFG는 별도의 이미지 분류기 모델 없이, 하나의 신경망을 훈련할 때 조건 텍스트 $c$를 10~20% 확률로 빈 문자열($\\emptyset$)로 비워두는 '무조건부(Unconditional)' 학습을 병행합니다.
추론 시 모델은 두 번의 노이즈 예측을 수행하고 이들을 다음과 같이 조합합니다:
$$\\tilde{\epsilon}_\\theta(z_t, c) = \\epsilon_\\theta(z_t, \\emptyset) + s \\cdot \\left( \\epsilon_\\theta(z_t, c) - \\epsilon_\\theta(z_t, \\emptyset) \\right)$$
\`\`\` [ CFG 스케일(s)의 기하학적 벡터 합성 원리 ]
무조건부 노이즈 예측 ε(z_t, ∅) (일반적인 그럴듯한 이미지 방향) ● ╱│ ╱ │ ╱ │ 조건부 차이 벡터: [ ε(z_t, c) - ε(z_t, ∅) ] ╱ │ ("프롬프트에만 고유하게 존재하는 특징의 방향") ╱ ▼ ●─────► ● 최종 유도 노이즈 ε~ (s 배율로 차이를 대폭 증폭!) 조건부 노이즈 ε(z_t, c) \`\`\`
6. 차세대 아키텍처: DiT(Diffusion Transformer)와 플로우 매칭(Flow Matching)
2024~2026년 생성형 AI 생태계는 10년간 군림해 온 합성곱 기반 U-Net을 버리고 새로운 패러다임으로 급격히 전환되었습니다.
▶ 6.1 DiT (Diffusion Transformer)와 스케일링 법칙
윌리엄 피블스(William Peebles)와 카이밍 허(Kaiming He)의 제자 셰치펑(Saining Xie)이 2023년 발표한 DiT(Diffusion Transformer)는 U-Net의 계층적 다운샘플링/업샘플링 구조를 완전히 제거했습니다.▶ 6.2 플로우 매칭 (Flow Matching)과 정류 흐름 (Rectified Flow)
기존 DDPM/SDE의 가장 큰 수학적 비효율은 확산 궤적이 구불구불한 곡선(Curved Trajectory)을 그린다는 점이었습니다. 곡선 경로를 따라 적분해야 하므로 여러 번의 오일러 스텝이 필요했습니다.Lipman et al.(2023)과 Liu et al.(2022)의 플로우 매칭 / 렉티파이드 플로우(Rectified Flow)는 최적 수송(Optimal Transport) 이론을 도입하여, 가우스 노이즈 $x_1$에서 데이터 $x_0$까지의 궤적을 완벽한 직선(Straight Lines)으로 연결합니다.